Professionnel
Supervision PostgreSQL / TimescaleDB avec Zabbix
Conception d'un template Zabbix 7.0 pour superviser le stockage PostgreSQL et TimescaleDB : un collecteur Python découvre bases, tables et hypertables, avec scripts d'installation et de vérification.
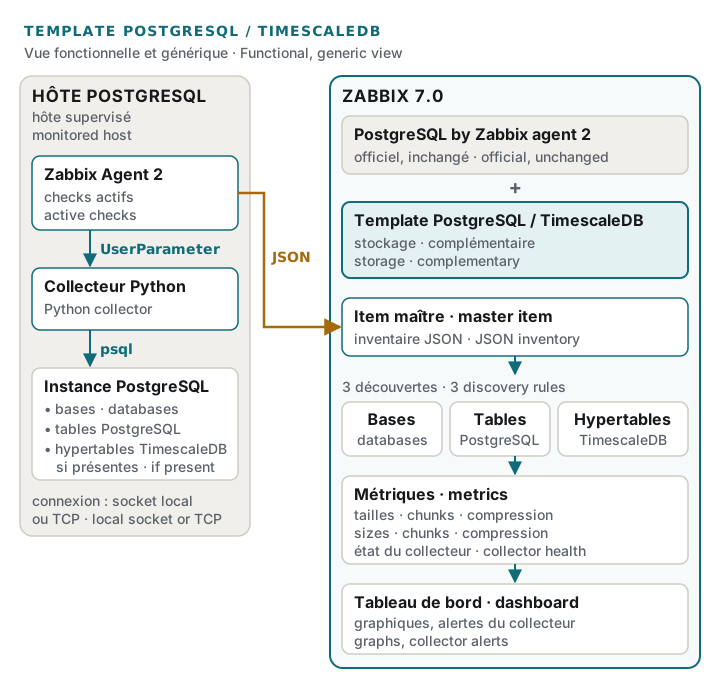
Projet réalisé dans un cadre professionnel : la présentation est volontairement généralisée.
Ma contribution
Conception et développement du template et de son collecteur : découverte des bases, tables et hypertables, collecte des tailles des tables, index et TOAST, suivi des chunks, de la compression et de l’état de la collecte. Réalisation des scripts d’installation, de vérification préalable et de désinstallation, et de tests hors ligne. Prise en charge des modes de connexion local, par socket Unix avec authentification peer, et TCP.
Points clés
- Découverte automatique des bases, tables et hypertables PostgreSQL / TimescaleDB
- Tailles des tables, index, TOAST et totales ; chunks et compression
- Collecteur Python lancé par Zabbix Agent 2, un document JSON par cycle
- Scripts d'installation, de vérification préalable et de désinstallation
- Prise en charge des modes local (socket Unix, peer) et TCP
Contexte
Une base PostgreSQL qui stocke des séries temporelles grossit en continu, et l’essentiel de ce volume se concentre dans quelques tables. Avec TimescaleDB, ces tables sont des hypertables, découpées en chunks. Savoir que le disque se remplit ne suffit pas : il faut voir quelles tables grossissent, et à quel rythme.
Objectif
Disposer dans Zabbix d’un suivi du stockage au niveau des tables, réutilisable d’une base à l’autre sans configuration manuelle table par table, en complément du template officiel PostgreSQL by Zabbix agent 2, qui reste inchangé.
Fonctionnement général
- Collecte. Zabbix Agent 2 lance, via un UserParameter, un collecteur Python qui interroge
l’instance avec
psqlet renvoie un seul document JSON à chaque cycle. - Découverte. Trois découvertes s’appuient sur ce document : bases, tables PostgreSQL et hypertables TimescaleDB. Aucun nom de base ni de table n’est codé en dur.
- Métriques de stockage. Pour chaque table découverte : taille de la table, des index, des données TOAST, autre et totale. Pour les hypertables : nombre de chunks, chunks compressés et non compressés, compression activée.
- État de la collecte. Durée, erreurs et avertissements, collecte partielle, bases injoignables. Les alertes portent sur cette santé de la collecte ; les macros du template règlent notamment les filtres de découverte et l’intervalle de collecte.
- Tableau de bord. « PostgreSQL / TimescaleDB storage » regroupe les graphiques par base, table et hypertable, les chunks et l’état du collecteur.
- Installation. Des scripts d’installation et de désinstallation, et une vérification préalable de l’installation, du mode de connexion et de l’exécution du collecteur avant déploiement, accompagnés de tests hors ligne.
- Deux modes de connexion. Socket Unix local avec authentification peer, ou connexion TCP.
Résultat
Un template fonctionnel pour Zabbix 7.0, livré en version 1.1.0 avec ses scripts d’installation, de vérification et de désinstallation et des tests hors ligne. Il prend en charge une connexion locale par socket Unix avec authentification peer, ainsi qu’une connexion TCP.